
หลังจากตรากตรำกับการเขียนงานวิจัยมาหลายเดือน ในที่สุดก็มีเวลาว่างได้พักกายพักใจซักที
พอหัวมันโล่งก็พอคิดไปถึงเรื่องหลายๆอย่างที่อยากทำ หนึ่งในนั้นคืออยากลองเล่นเจ้าMLX(https://github.com/ml-explore/mlx) ที่appleเปิดตัวมาได้ซักพักใหญ่ๆ ที่เป็นarray frameworkสำหรับapple siliconโดยเฉพาะ ถ้าใครนึกภาพไม่ออกมันคือNumPyที่optimizeมาสำหรับเครื่องMacนั่นแหละ โดยข้อดีหลักๆของเจ้าMLXอ้างอิงจากหน้าgithubเค้าบอกว่า
APIเหมือนNumPyหรือPyTorchเลย ถ้าใครคุ้นเคยกับสองตัวนี้อยู่แล้วน่าจะปรับตัวได้ไม่ยาก
ใช้ประโยชน์จากunified memoryได้อย่างเต็มที่ ข้อดีทำให้การคำนวณด้วยgpuไม่มีoverheadsจากการคักลอกข้อมูลขึ้นไปที่ramของgpu และโค็ดที่สั่งคำนวณบนcpuหรือgpuก็ทำได้ค่อนข้างตรงไปตรงมาโดยไม่ต้องมีการcopyตัวแปร ดังตัวอย่างด้านล่าง
a = mx.random.normal((100,))
b = mx.random.normal((100,))
mx.add(a, b, stream=mx.cpu)
mx.add(a, b, stream=mx.gpu)
ในฐานะที่ใช้NumPyทำงานมาตลอดเพราะdataที่ไม่ใหญ่มากนั้นcpuยังทำงานได้เร็วพอ นานๆทีจะมีdataใหญ่มากพอให้ต้องการการคำนวณบนGPU ซึ่งกรณีนี้ก็มักจะใช้บริการPyTorchซึ่งมี Metal Performance Shaders (MPS) backendสำหรับเรียกใช้gpuบนmacได้อยู่แล้ว ด้วยความที่PyTorchได้รับความนิยมในวงกว้างมากกว่าในงานAI,ML รวมถึงซัพพอร์ทOSและdeviceที่เยอะกว่า อยู่ๆจะหันไปใช้MLXที่เฉพาะเจาะจงกว่าทำไมถ้ามันไม่เร็วกว่า จริงไหม?
ดังนั้นจึงต้องทดสอบ
ว่าแล้วก็ลงมือโหลดmlxมาลงแล้วเขียนbenchmarkซะเลย โดยการทดสอบจะทำโดยการจับเวลาการคูณเมทริคที่สุ่มมาไม่ซ้ำกัน10ครั้งแล้วใช้เวลาเฉลี่ย โดยคูณด้วยbackendsต่างๆดังนี้
NumPy (cpu)
Torch (cpu)
Torch (gpu by mps)
MLX (cpu)
MLX (gpu)
การคำนวณทั้งหมดใช้ตัวแปรความประเภทfloat32
สเปคเครื่องที่ใช้ทดสอบ Macbook Air M1 2020 (16GB) 7-cores gpu.
Package version: python3.13.3, mlx v0.25.0, pytorch v2.5.1, numpy 2.2.5
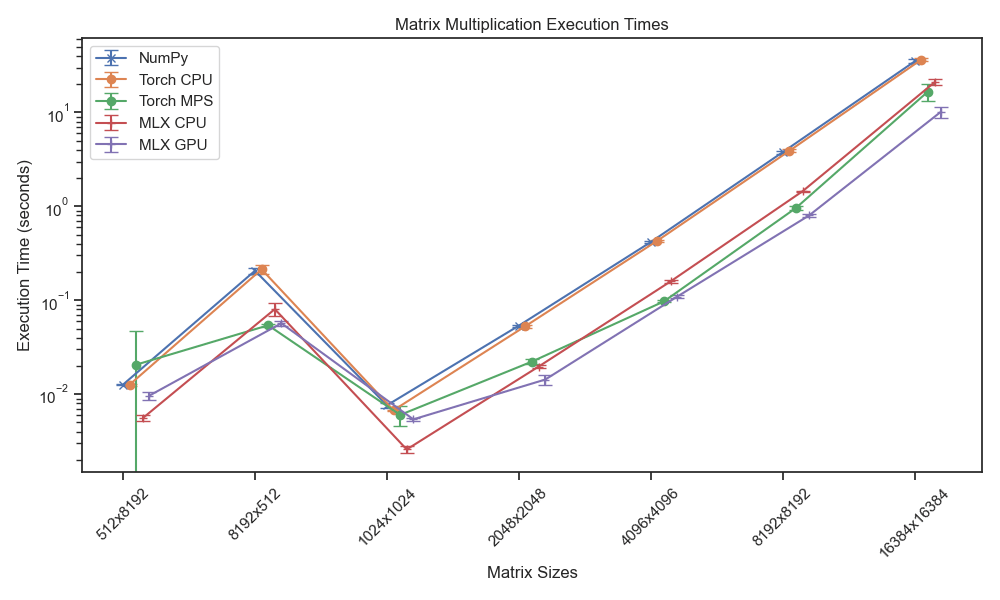
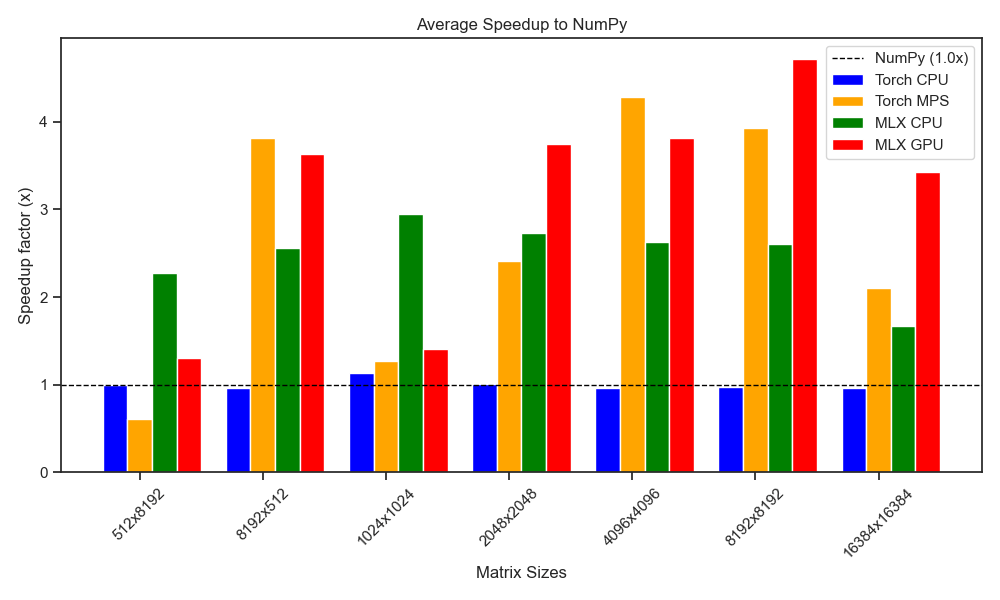
จากการทดสอบถือว่าน่าประทับใจทีเดียวสำหรับmlx โดยประสิทธิภาพของการใช้gpuระหว่างMLX(gpu)เร็วกว่าบนTorch(mps)หรือใกล้เคียง ซึ่งน่าจะเป็นผลมาจากการใช้unified memoryช่วยประหยัดเวลาจากการส่งข้อมูลขึ้นแรมgpuนั่นเอง
ที่น่าประหลาดใจคือความเร็วของ MLX(cpu)มีspeedupดีกว่าTorch(cpu)กับNumPyอย่างชัดเจน(สองอย่างหลังแทบไม่ต่างกัน) แถมบางกรณียังเทียบเคียงgpuได้เลยทีเดียว ซึ่งจากการตรวจสอบคาดว่าสาเหตุน่าจะมาจากMLX(cpu)มีการใช้งานefficient coreในการคำนวณด้วย ในขณะที่NumPyกับTorch(cpu)ใช้แค่Performance coreเท่านั้น
สรุป: ประสิทธิภาพของMLXสำหรับการคูณเมทริคถือว่าน่าประทับใจมาก โดยหลักๆมาจากการใช้ประโยชน์ของunified memoryและการใช้งานcpuทั้งP-coresและE-cores
ดังนั้น MLXจึงเป็นตัวเลือกที่น่าสนใจอย่างมากสำหรับงานคำนวณบนฮาร์ดแวร์ที่ใช้apple silicon